Mon sitemap affichait « Réussi ». Google avait indexé 32 pages sur 345.
Search Console disait « Réussi » pour mes sitemaps, mais Google n'avait indexé que 32 pages sur 345. Comment je l'ai vu, et Indexing API, Bing, IndexNow et GEO.
La flemme de lire ?
Envoie-le à ton agent.
Il vérifie ton site en suivant mon guide et te dit quoi corriger.
Vérifie mon site en suivant ce guide : https://alexisamz.com/agents/audit-site.md

Lis-le en entier avant d'agir, puis demande-moi l'adresse de mon site.
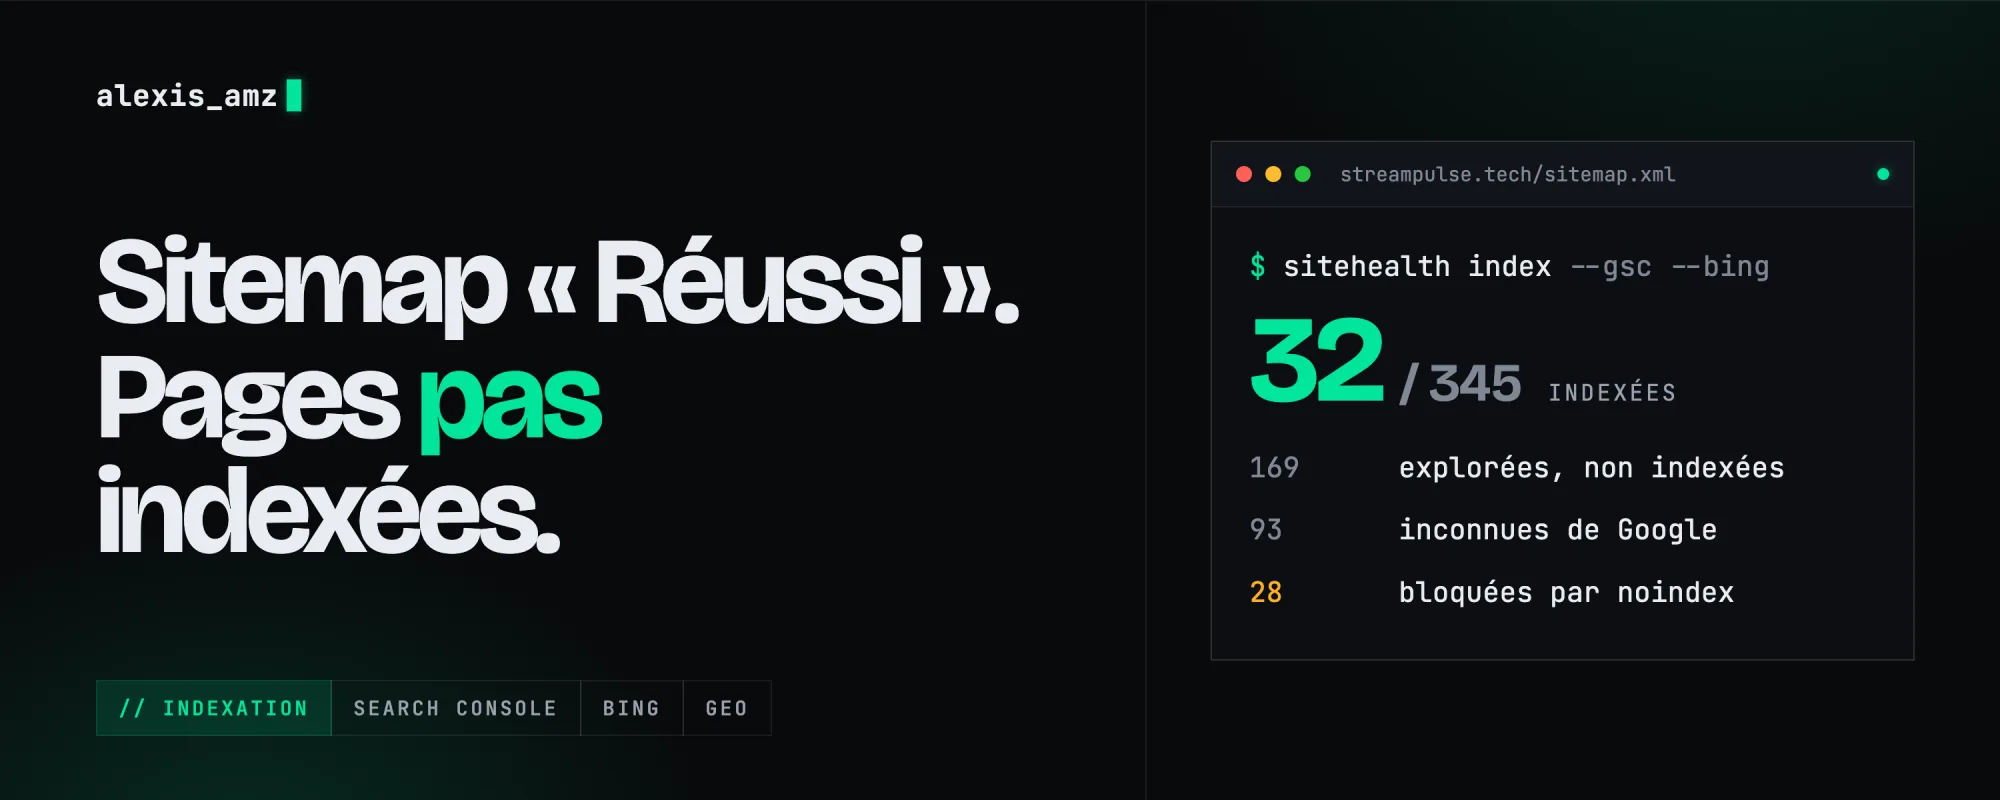
Dans la Search Console, tous mes sitemaps avaient le statut « Réussi ». J'ai vérifié les pages une par une. Sur mon site principal, 345 pages dans le sitemap, 32 indexées. Sur le site du salon de coiffure, 8 pages, une seule indexée. Voici comment je l'ai vu, et tout ce que j'ai mis en place derrière.
« Réussi » ne veut pas dire « indexé »
Ce statut veut juste dire que Google a pu lire le fichier, pas qu'il a gardé les pages. Pour savoir ce qui est vraiment indexé, il faut l'« Inspection de l'URL ». À la main, c'est une page à la fois. Avec l'API, 2 000 par jour et par site, et Google donne la raison pour chaque page refusée. Chez moi :
| Statut Google | Pages | Ce que ça veut dire |
|---|---|---|
| Explorée, non indexée | 169 | Il a lu la page et a décidé de ne pas la garder. |
| Inconnue | 93 | Il n'est jamais passé dessus. |
| Exclue par noindex | 28 | Il a vu une ancienne version où je bloquais la page. |
| Détectée, non indexée | 19 | Il sait qu'elle existe, il n'est pas encore venu. |
Les 169 refusées ne se règlent pas en les renvoyant. Chez moi, c'est sûrement parce que beaucoup de pages sont la même page déclinée en 11 langues. Là, il faut retravailler le contenu.
Créer le compte de service Google
Pour utiliser les API de Google, il faut un compte de service : un compte robot avec sa propre adresse e-mail. C'est l'étape où tout le monde bloque.
Le projet
- Allez sur
console.cloud.google.comavec le compte Google de votre Search Console. - En haut, à côté du logo, cliquez sur le sélecteur de projet, puis « Nouveau projet ». Un nom suffit, pas besoin de carte bancaire.
- Vérifiez que ce projet est bien sélectionné avant de continuer. Je me suis trompé la première fois.
Les API
- Dans le menu principal : « API et services », puis « Bibliothèque ».
- Activez « Google Search Console API », puis « Web Search Indexing API ».
Si vous l'oubliez, vos scripts reçoivent une erreur 403 qui parle d'API « disabled ».
Le compte et sa clé
- Dans le menu principal : « IAM et administration », « Comptes de service », puis « Créer un compte de service ».
- Donnez un nom. L'adresse se crée toute seule (
[email protected]). Copiez-la. - « Créer et continuer ». Les rôles proposés ne servent à rien ici, passez. Puis « OK ».
- Ouvrez le compte, onglet « Clés », « Ajouter une clé », « Créer une clé », format JSON. Le fichier téléchargé, c'est la clé. Jamais dans un dépôt Git, jamais envoyée à quelqu'un.
Si Google refuse de créer la clé, c'est une règle de sécurité des comptes Google Workspace récents. Elle se désactive dans « IAM et administration », « Règles d'administration » (cherchez « Disable service account key creation »). Ou créez le projet avec un Gmail perso.
L'accès dans la Search Console
- Pour chaque site : « Paramètres », « Utilisateurs et autorisations », « Ajouter un utilisateur ».
- Collez l'adresse du compte de service, choisissez « Propriétaire ». L'Indexing API refuse tout sinon.
Je l'avais fait sur 3 sites sur 6 sans m'en rendre compte. Et un site a mis quelques minutes à apparaître côté API après l'ajout : si ça ne marche pas tout de suite, attendez un peu.
Ce qu'il faut savoir sur l'Indexing API
C'est 200 URL par jour, tous sites confondus. Et Google la réserve officiellement aux offres d'emploi et aux vidéos en direct : sur une page normale, ça fait souvent passer le robot plus vite, sans garantie. J'avais préparé un calendrier d'envoi il y a quelques jours. En vérifiant avec l'API : 0 URL envoyée sur 368. Je ne l'avais jamais lancé. Maintenant, mon calendrier est un fichier que j'importe dans mon agenda, avec la commande du jour.
Bing, qu'on oublie toujours
L'index de Bing sert aussi à DuckDuckGo, Ecosia, Yahoo et à la recherche web de ChatGPT. Sur bing.com/webmasters, « Importer depuis Google Search Console » ramène tous vos sites d'un coup, déjà vérifiés. Pour l'API : la roue dentée des paramètres, « Accès API », puis « Clé API », une seule clé pour tous les sites. Sur Mac, je la range dans le trousseau :
security add-generic-password -a "$USER" -s bing-webmaster-api -w
(Moi, je l'avais d'abord collée dans un chat. Si ça vous arrive, régénérez-la.)
IndexNow, le plus simple de tous
- Inventez une clé : une suite de lettres et de chiffres.
- Mettez un fichier
votre-cle.txtqui contient la clé à la racine du site (danspublic/sur Next.js). - Ouvrez
monsite.com/votre-cle.txt: vous devez voir la clé, pas une page d'erreur. - Envoyez vos URL en une requête :
curl -X POST https://api.indexnow.org/indexnow \
  -H "Content-Type: application/json; charset=utf-8" \
  -d '{"host":"monsite.com","key":"votre-cle",
       "urlList":["https://monsite.com/","https://monsite.com/page"]}'
Bing, Yandex, Seznam et Naver sont prévenus. Google ne participe pas. La première réponse est 202 au lieu de 200 : c'est normal, la clé est en cours de validation. Envoyez tout le site une fois, ensuite seulement ce qui change.
Changement de domaine
Quand je suis passé de .fr à .tech, j'ai cherché l'outil « Site Move » de Bing dont parlent tous les tutos. Il n'existe plus. Ce qui compte, ce sont les redirections permanentes page par page : ancien.fr/page vers nouveau.tech/page, pas vers l'accueil. Chez Google, « Changement d'adresse » existe toujours, dans les paramètres de l'ancien site.
Le GEO : se faire citer par les IA
Le GEO, c'est faire en sorte que ChatGPT, Perplexity ou Gemini comprennent votre site et le citent. Personne ne peut le garantir, mais il y a des bases.
Être dans les index qu'elles utilisent
- ChatGPT (recherche) et Copilot s'appuient surtout sur Bing.
- Gemini et les AI Overviews s'appuient sur Google.
- Perplexity a son propre robot et utilise d'autres index.
Donc tout ce qui précède, c'est déjà du GEO.
Ne pas bloquer leurs robots
Chaque IA a plusieurs robots, réglables un par un dans robots.txt. On peut refuser l'entraînement tout en restant citable :
| Robot | Ce qu'il fait |
|---|---|
| OAI-SearchBot | La recherche de ChatGPT. C'est lui qui vous fait citer. |
| GPTBot | L'entraînement des modèles d'OpenAI. |
| PerplexityBot | L'index de Perplexity. |
| ClaudeBot | L'entraînement des modèles d'Anthropic. |
| Google-Extended | L'usage par Gemini, sans effet sur la recherche Google. |
Regardez aussi votre pare-feu : Cloudflare a une option qui bloque les robots d'IA.
Un fichier llms.txt
Un petit fichier en Markdown à la racine, qui résume le site et liste les pages clés. Pas un standard officiel, Google ne s'en sert pas, mais certains outils d'IA le lisent et ça prend dix minutes. Celui de ce site est ici.
# MonSite
> Une phrase qui dit ce que c'est et pour qui.

## Pages principales
- [Fonction X](https://monsite.com/x) : ce qu'elle fait.
- [Tarifs](https://monsite.com/prix) : les vrais prix.
Écrire des pages qu'on a envie de citer
Une IA reprend une phrase qui répond seule à une question. « Marche sur Chrome, Edge, Brave et Opera » peut être cité tel quel. « Compatible avec tous les navigateurs » ne dit rien, donc personne ne le reprend.
Pour mesurer, je pose régulièrement les mêmes questions à ChatGPT et Perplexity, et je regarde les visites qui viennent de chatgpt.com dans mes stats.
Tout ça, c'est ce que fait mon skill amz-site-health pour moi maintenant (la boîte à outils complète). Article suivant : Impeccable, le skill de design que j'installe partout.
Site web, shooting photo ou vidéo.
Discutons-en.